
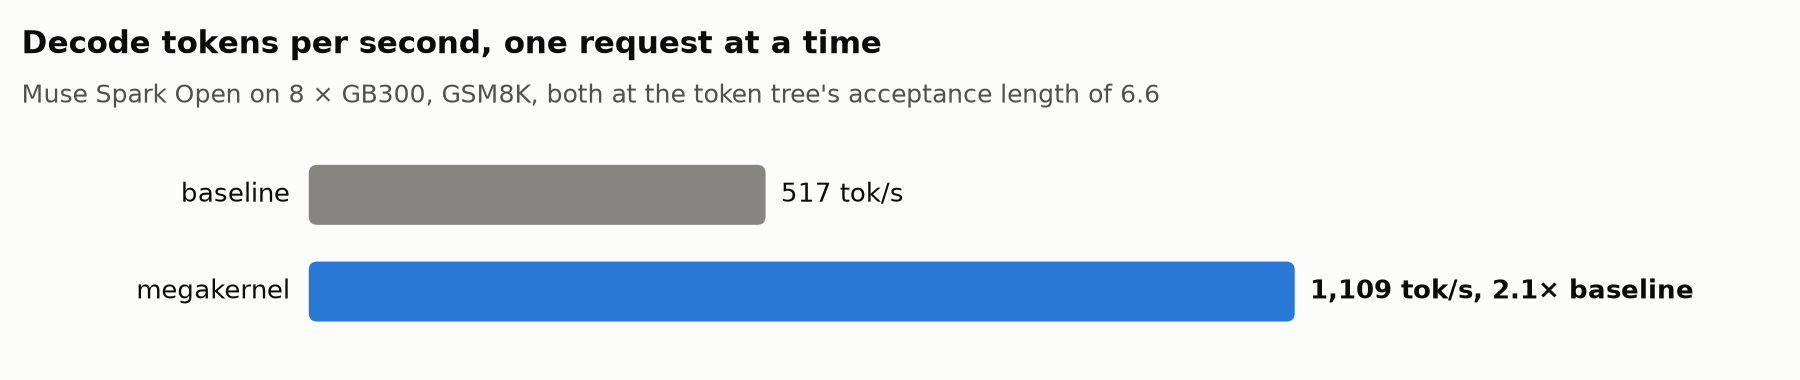
SGLang与ML基础设施正转向更大规模的GPU核——megakernel。本文从零用CUDA C++和PTX为Muse Spark Open构建megakernel,将Blackwell GPU单请求解码速度从517 tok/s提升至1109 tok/s。
Muse Spark Open采用传统MoE结构,每个token路由至256专家中的8个,专家权重以4位NVFP4存储,含62个解码层。
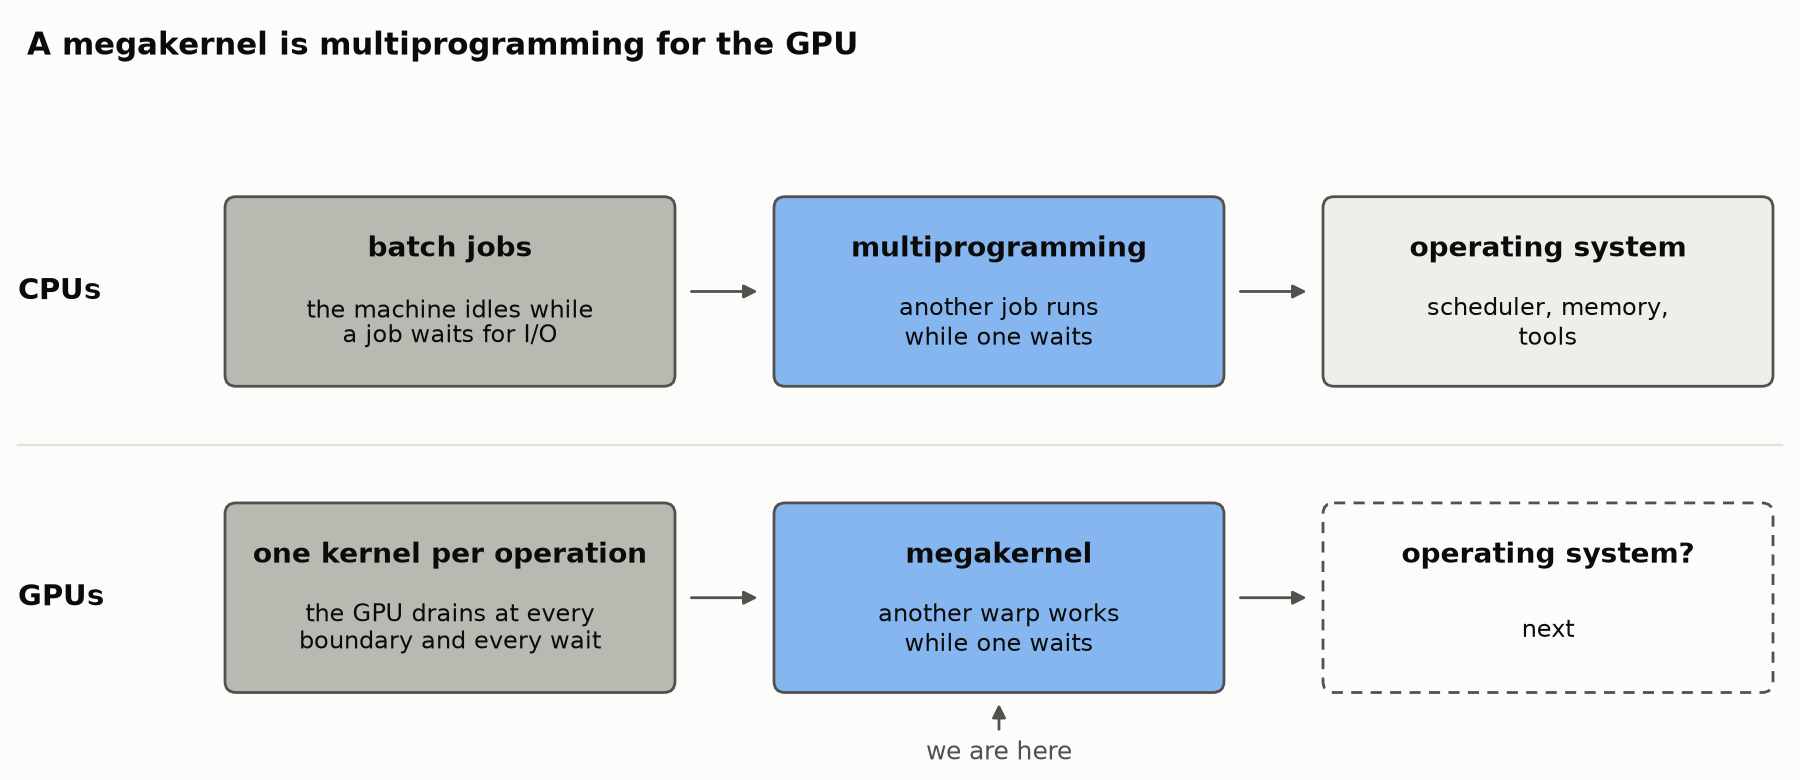
什么是megakernel?
普通GPU核仅执行单一操作,服务引擎需发射约1450个核完成一次解码步。若未充分优化,核间GPU会出现空闲。megakernel则让单一核常驻所有SM,同时运行多种任务,保持张量核、TMA、NVLink等引擎全速运转。
模型与新张量并行
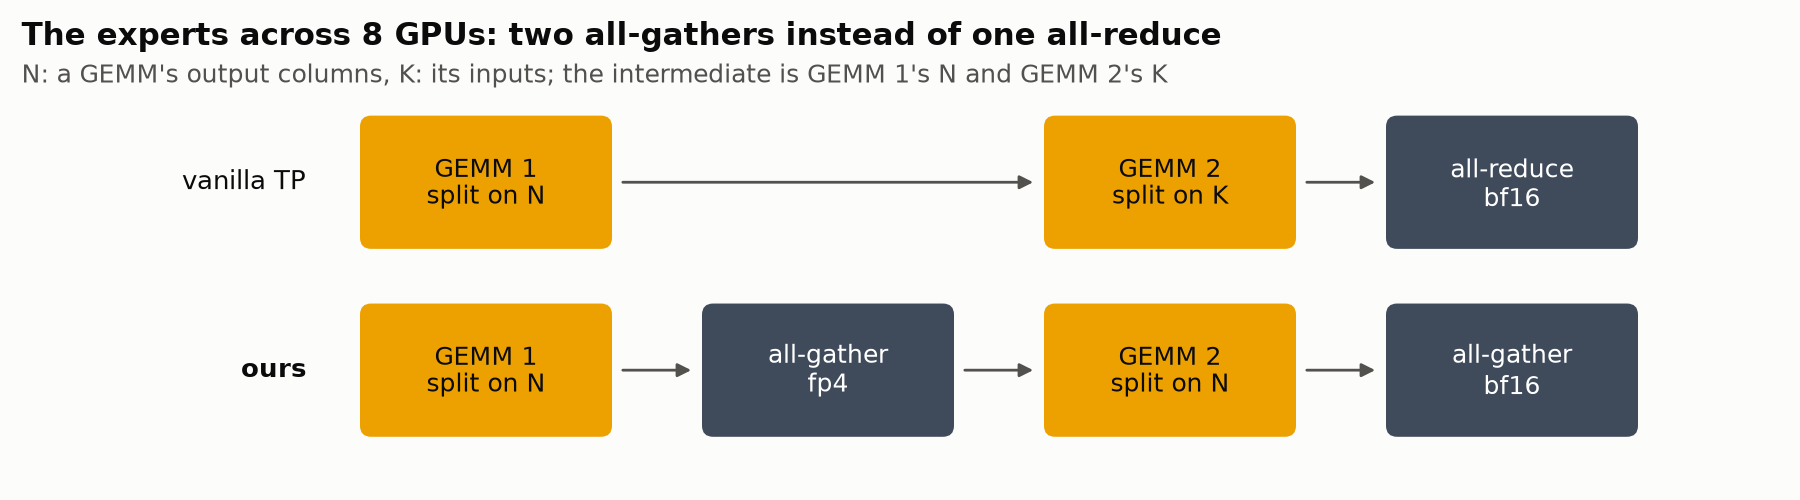
模型在8张GPU上以TP8划分。传统TP在两个MoE GEMM间仅一次all-reduce,而新方案在N维切分两个GEMM,引入fp4 all-gather与bf16 all-gather,虽多一步通信但总体通信量更低,扩展性更好。
megakernel实现
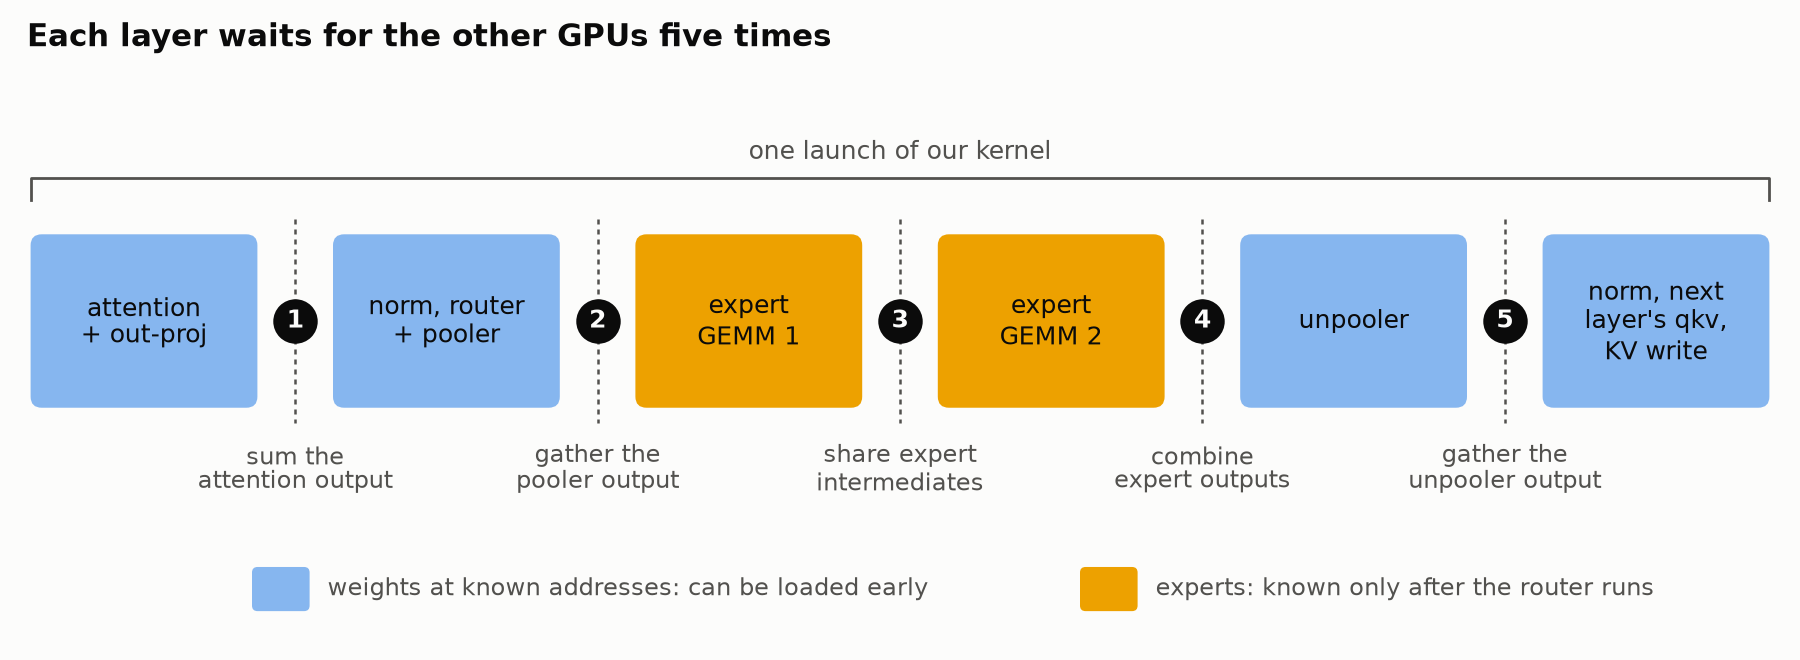
每层仅发射一次核,覆盖从本层attention到下一层qkv投影与KV写入。每个核在144个SM上放置12个warp,不同warp分别负责KV加载、权重预取、张量核计算、SwiGLU及all-gather/reduce。
性能与投机解码
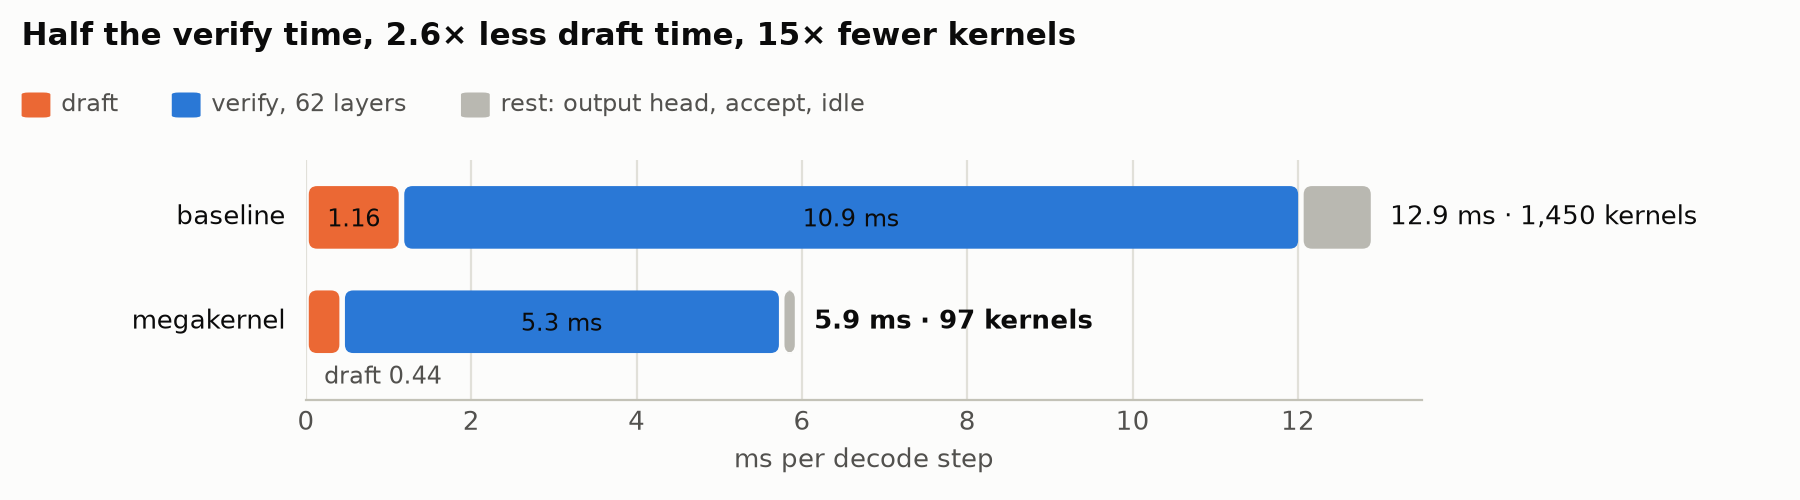
单步解码耗时从12.9 ms降至5.9 ms,核数量从1450减至97。配合DFlash V2 draft模型,每步验证16 token,平均接受6.6 token,达到1109 tok/s。
megakernel内部优化
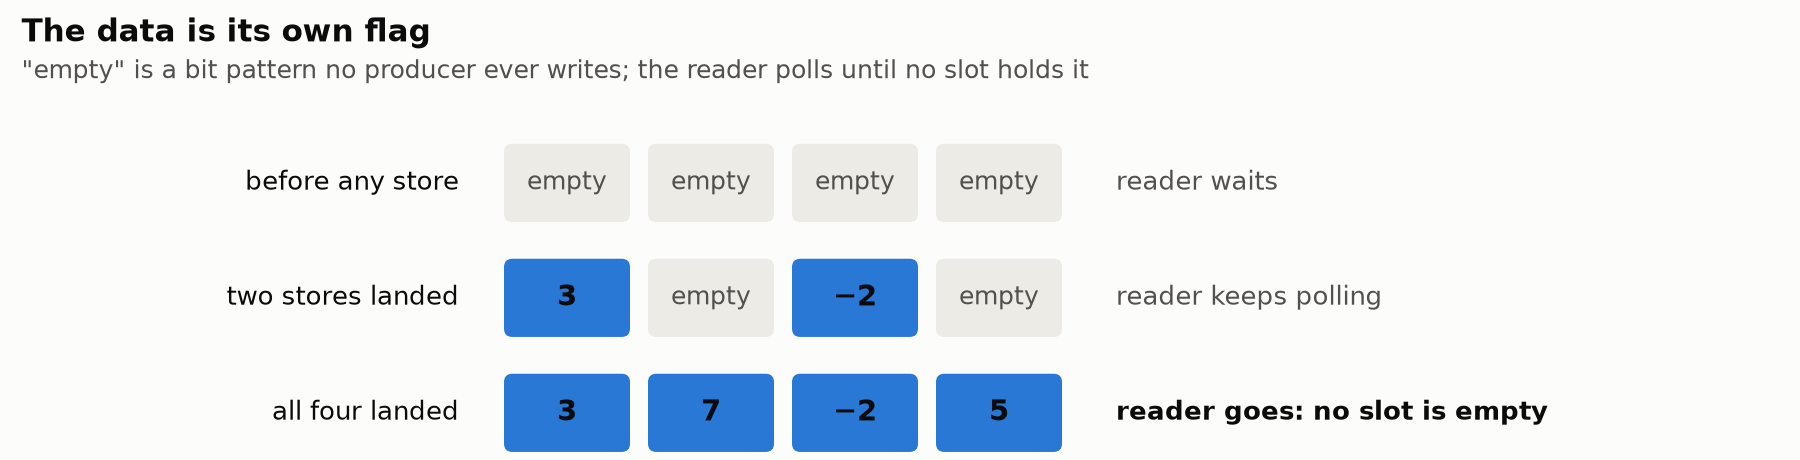
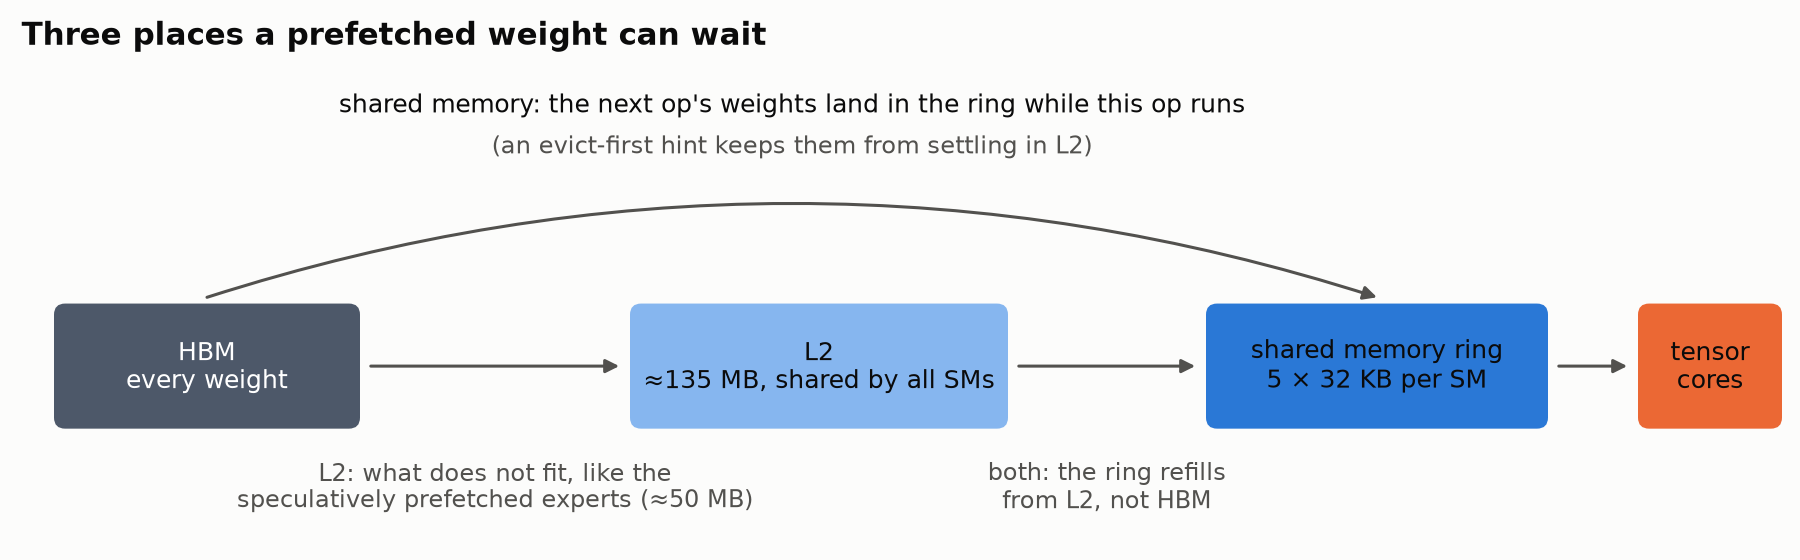
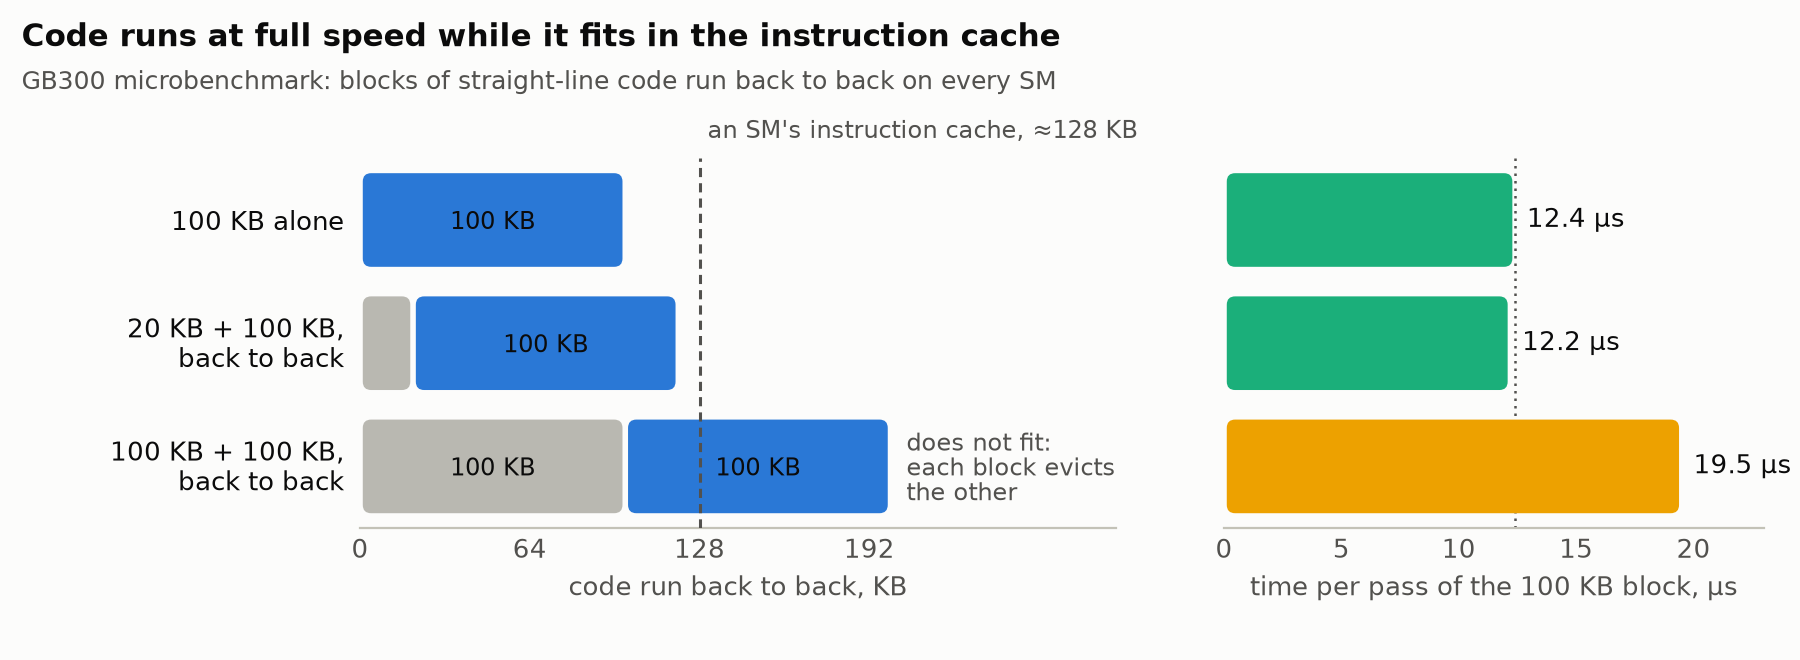
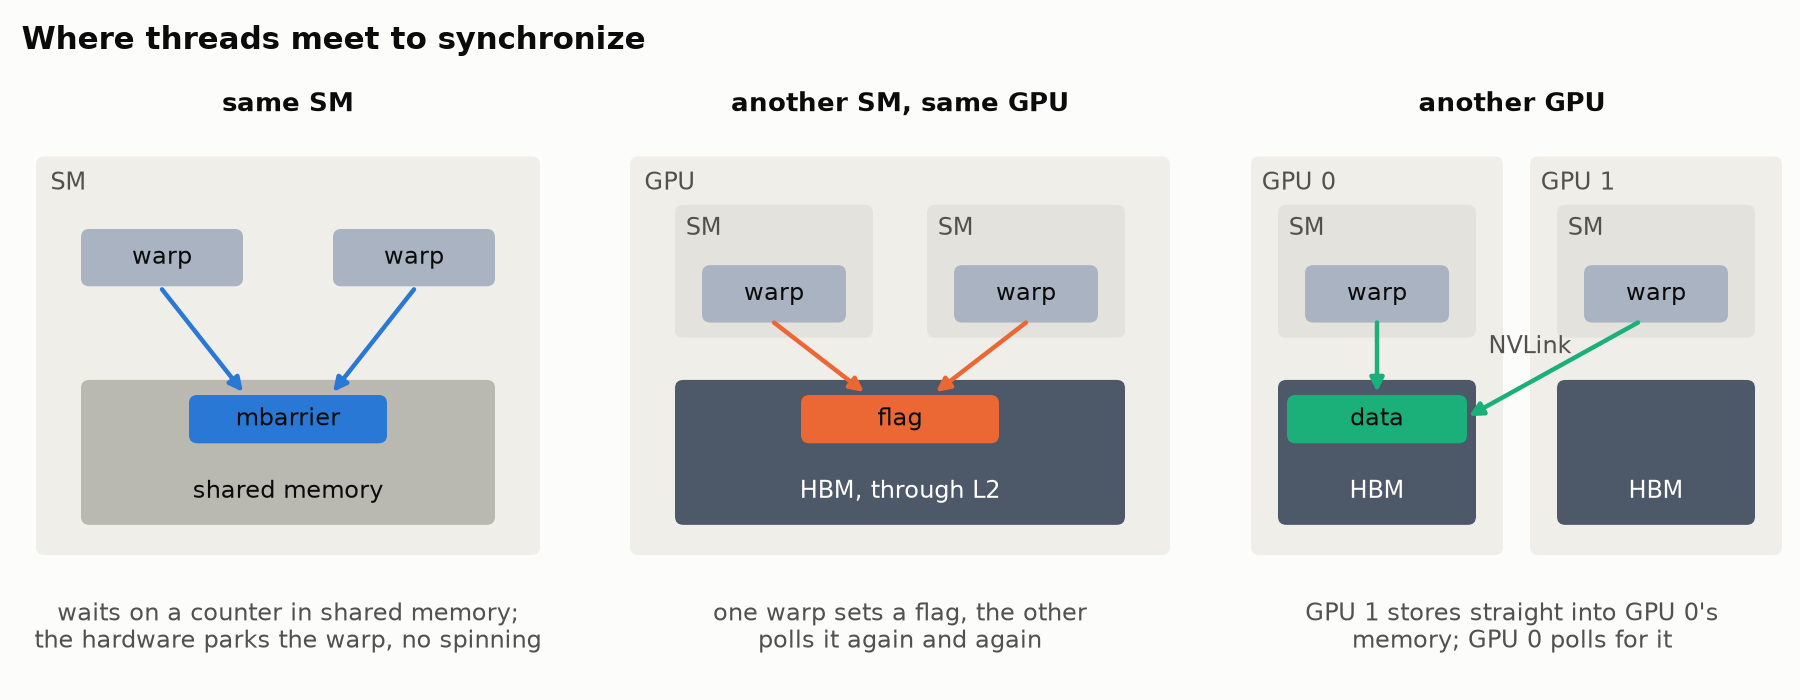
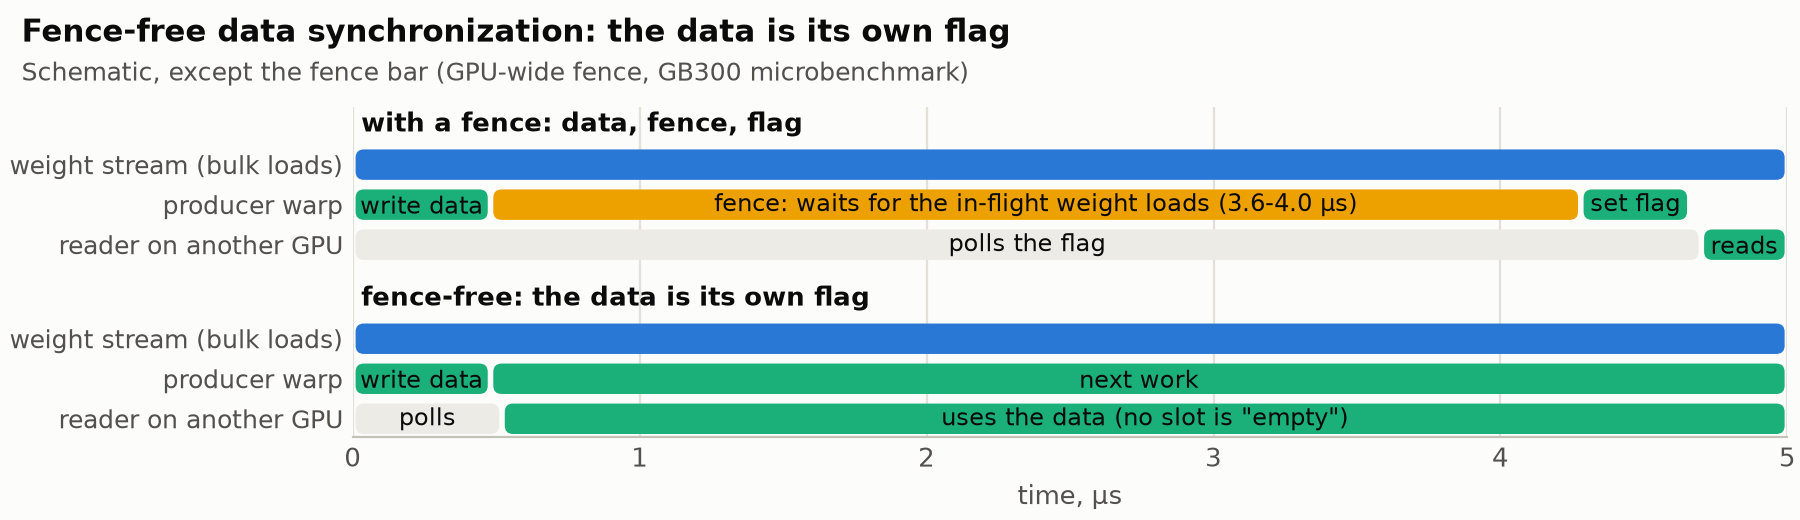
通过权重全缓存预取、指令缓存管理、多级同步(shared memory mbarrier、HBM flag、NVLink直接store)及无fence数据同步,实现近乎完美重叠。
展望
未来将支持更大批次,并向GPU操作系统方向演进。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接