
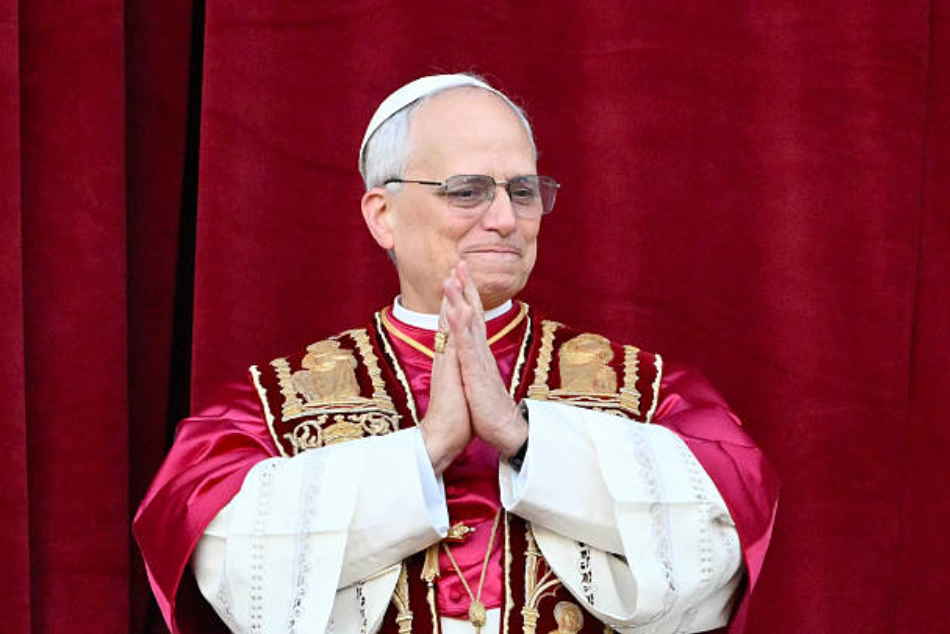
当生成式人工智能以几乎每周一个新模型的速度席卷创意产业时,梵蒂冈发出了迄今为止最直白的一次批评。教皇利奥十四世在近日的一次公开讲话中明确表达了对AI生成艺术的否定态度,并把矛头指向了这类技术最根本的合法性来源——它并不“创造”,它只是“计算”。
据TechCrunch报道,教皇的核心论点并不在于AI作品好不好看,而在于它压根不属于艺术这个范畴。这一表述迅速在科技圈与艺术圈同时引发讨论,因为它触及了生成式AI最敏感的那根神经:机器能否成为创作者。
“算法缺乏人类火花”
“There is an ontological difference, even before an aesthetic one, between art and what a machine can generate through statistical calculation based on millions of images created by others. Algorithms lack the spark of humanity.”(艺术与机器基于他人创作之数百万图像进行统计计算所生成之物,首先存在的是本体论差异,其次才是美学差异。算法缺乏人类的那一簇火花。)
这段话的措辞值得逐字拆解。教皇没有说AI作品“不够美”,也没有说它“缺乏情感”——这些都是常见的、可被反驳的批评。他强调的是“ontological difference”,即存在层面的差别:一件艺术作品之所以是艺术,不在于它的成品形态,而在于它由一个有意识、有生命经验的主体,在特定处境中做出选择并承担后果。而机器所做的是概率分布上的拟合与采样,前者是“选择”,后者只是“输出”。
“统计计算”与“他人创作的数百万张图像”这两个限定词同样杀伤力十足。它们同时指向了两个长期争议:其一,AI并不理解图像的意义,它只是在模仿像素之间的统计关系;其二,也是更棘手的一点——训练数据的来源本身属于他人。
为什么这场争论不只是审美问题
如果只看表面,教皇的表态像是一次传统宗教机构对新兴技术的保守反应。但把它放回2026年的产业语境,会发现它其实精准命中了生成式AI商业模式中最脆弱的一环。
过去三年,图像生成模型的训练数据几乎全部来自公开互联网上的人类作品。大量插画师、摄影师、概念设计师发现,自己的作品在未经授权的情况下成为模型能力的来源,而模型产出的成品又在同一市场上与自己竞争。围绕这一点的法律行动从未停歇:从Getty Images对Stability AI提起的诉讼,到多名艺术家发起的集体诉讼,再到各国监管机构对训练数据合法性的反复问询,核心争议始终是同一个问题——机器的“学习”与人类的“借鉴”,是不是一回事?
教皇用“本体论差异”这个词,实际上给出了一个神学与哲学层面的回答:不是。人类的借鉴伴随着理解、取舍与责任,而算法的计算不承担任何东西。
梵蒂冈并非第一次谈AI
值得注意的是,这并非梵蒂冈首次就人工智能发声。早在2020年,教廷就参与推动了《罗马人工智能伦理呼吁》,主张AI的发展必须以人类尊严为核心,强调透明、包容、责任与公正。2025年初,梵蒂冈又发布了一份名为《古老与新颖》的文件,专门讨论人工智能与人类智能的关系,明确指出AI无论多强大,都只是在模拟人类智能的某些功能,而非复制人的整体性。
在这样的脉络下,教皇利奥十四世此次针对AI艺术的表态并不突兀,而是教廷一贯立场的延续与具体化:从抽象的伦理原则,落到一个可以被普通人立刻感知的领域——艺术创作。
艺术界的反应:一场没有中间地带的辩论
在创意行业内部,对这一表态的反应明显分裂。一部分独立艺术家与插画师社群对此表示欢迎,认为这是对“创作被数据化”的一次高规格反击,也是他们多年呼吁的“人类创作应被区别对待”在国际舆论场上的放大。
另一部分声音则指出,把“人类火花”作为区分标准,在实践层面很难操作。许多当代艺术实践本身已经包含算法生成、程序化构图、随机过程等元素;若严格按此标准划线,一部分被广泛承认的现代艺术作品也会被排除在外。更现实的担忧是,这种论述可能被用于推动过度的监管,进而抬高创作工具的使用门槛,最终受损的仍是资源有限的中小创作者。
编者按:这是一场关于“意义”的争论
教皇的发言之所以值得科技媒体认真对待,不是因为它能直接决定AI图像生成的合法与否,而是因为它把辩论的坐标从“技术能力”挪回了“意义来源”。过去几年,行业讨论AI艺术时,焦点往往集中在画质、风格控制、生成速度与成本上,仿佛只要机器画得足够好,问题就不存在了。而教皇提出的问题是:画得好,是不是就等于画?
这个问题没有技术答案。它需要由法律、市场与社会共识共同回答——版权制度要界定训练与生成的边界,市场要决定是否为人类创作保留溢价空间,而公众要决定自己在多大程度上接受由统计计算产出的“美”。
可以预见的是,随着生成模型能力继续增强,这类价值层面的冲突只会愈发尖锐。技术路线可以迭代,模型参数可以扩展,但“谁才是作者”这个问题,最终不会由算力给出答案。
本文编译自TechCrunch
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接