
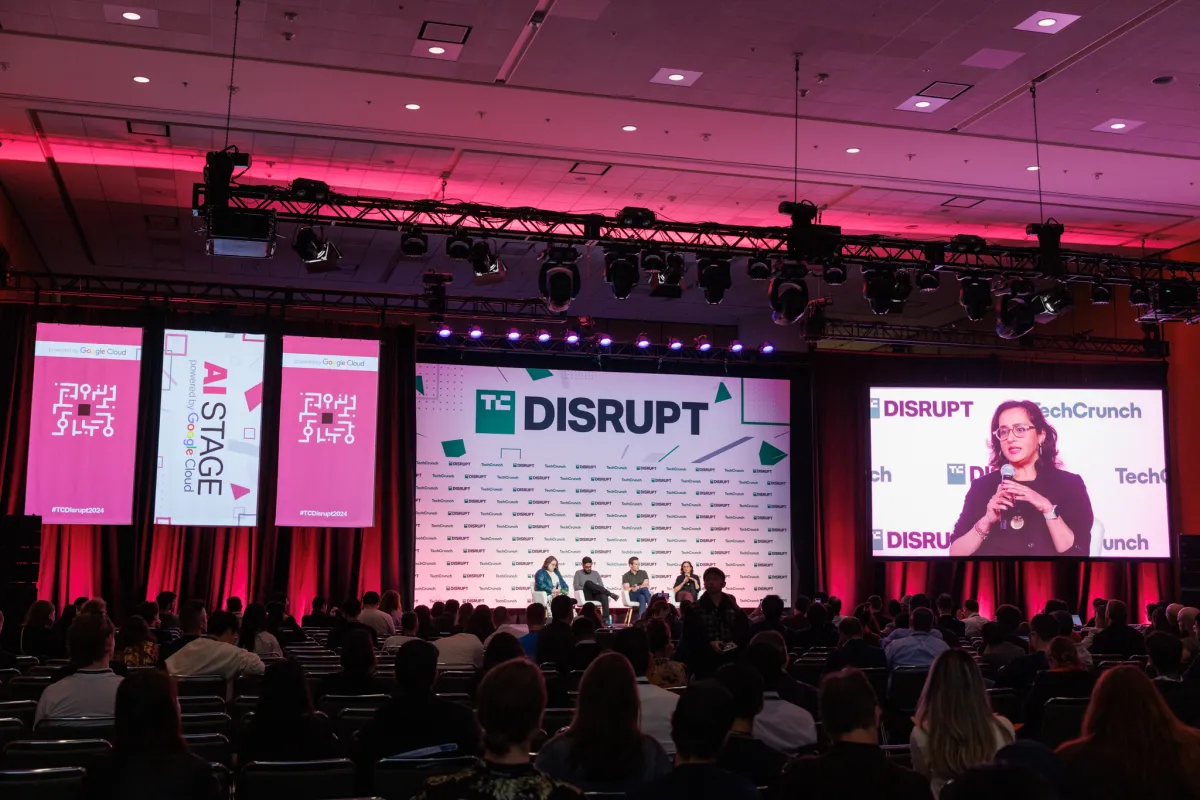
编者按:当大模型的军备竞赛进入第四个年头,“该在开源模型还是闭源模型上构建产品”已经从技术讨论变成了创始人的战略选择题。在 TechCrunch Disrupt 2026 的一场圆桌讨论中,多位创始人分享了他们的真实决策过程——答案远比“开源更便宜、闭源更强”这种简单二分法复杂。
据 TechCrunch 报道,这场名为“Open or closed AI?”的对话聚集了来自基础设施、应用层与垂直行业的创业者。他们面对的是一道每天都在变化的题目:模型能力、推理成本与合规要求几乎以季度为单位刷新,任何一次押注都可能在半年后变成包袱。
开源与闭源的边界正在消失
过去两年,开源权重模型的性能快速逼近前沿闭源模型。Llama 系列、Mistral、Qwen、DeepSeek 等模型的迭代,让“开源等于落后一代”的刻板印象基本失效。与此同时,头部闭源厂商也在开放部分能力接口、推出可微调版本,双方的商业模式开始互相渗透。
对创业者而言,这意味着单纯的“模型选型”不再构成护城河。真正的差异来自数据飞轮、工作流编排与用户场景理解——模型只是可替换的组件。
成本、延迟与合规:三重权衡
讨论中反复出现的三个变量是成本、延迟与合规。开源模型可以自托管,边际推理成本可控,数据不出自有环境,适合对隐私敏感的医疗、金融与政企场景;但自建推理集群意味着前期资本开支和运维负担,小团队往往难以承受。
“我们不是在选模型,我们是在选未来十八个月里,谁替我们承担基础设施的不确定性。”——一位参与讨论的创始人
闭源 API 的优势在于开箱即用、能力上限高、无需维护 GPU 集群;代价是按量计费的不可预测性,以及供应商锁定风险。当模型厂商调整价格或弃用某个版本时,产品团队不得不被动跟进迁移。
混合架构成为默认答案
多位创始人的共识是:非此即彼的时代已经结束。一种典型做法是——用闭源前沿模型处理复杂推理与长尾请求,用开源小模型承接高频、低延迟、可标准化的调用;同时在抽象层上做统一封装,保留随时切换的能力。
这种“路由式”架构把选择权留在自己手里。工程师不再问“用哪个模型”,而是问“这个任务交给哪一层最划算”。
给创始人的三条建议
综合现场讨论,可以提炼出三点:第一,把模型抽象层当成核心基础设施来投资,避免业务逻辑与特定 API 深度耦合;第二,从第一天就建立成本与质量的度量体系,用数据而非直觉做切换决策;第三,评估合规与数据主权要求,因为它们往往比性能差异更早决定架构形态。
开放还是封闭,最终不是价值观之争,而是资源配置问题。对多数早期团队来说,正确答案不是“选边站”,而是保持架构的可迁移性——在模型能力飞速演进的窗口期,灵活性本身就是最稀缺的资产。
TechCrunch Disrupt 2026 的这场讨论也提醒人们:当底层技术每六个月重写一次规则时,创业者的核心竞争力不在于押中某个模型,而在于能否在变化中持续交付用户价值。
本文编译自TechCrunch
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接