
在人工智能行业,基准测试(benchmark)早已不只是技术细节,而是各家公司争夺话语权的“主战场”。OpenAI、Anthropic、Google DeepMind 等实验室在发布新模型时,几乎都会附上一张对比表格,用 MMLU、GPQA、SWE-bench 等一串缩写数字证明自己的产品更强。这套逻辑成立的前提是:评估是中立、准确、可复现的。
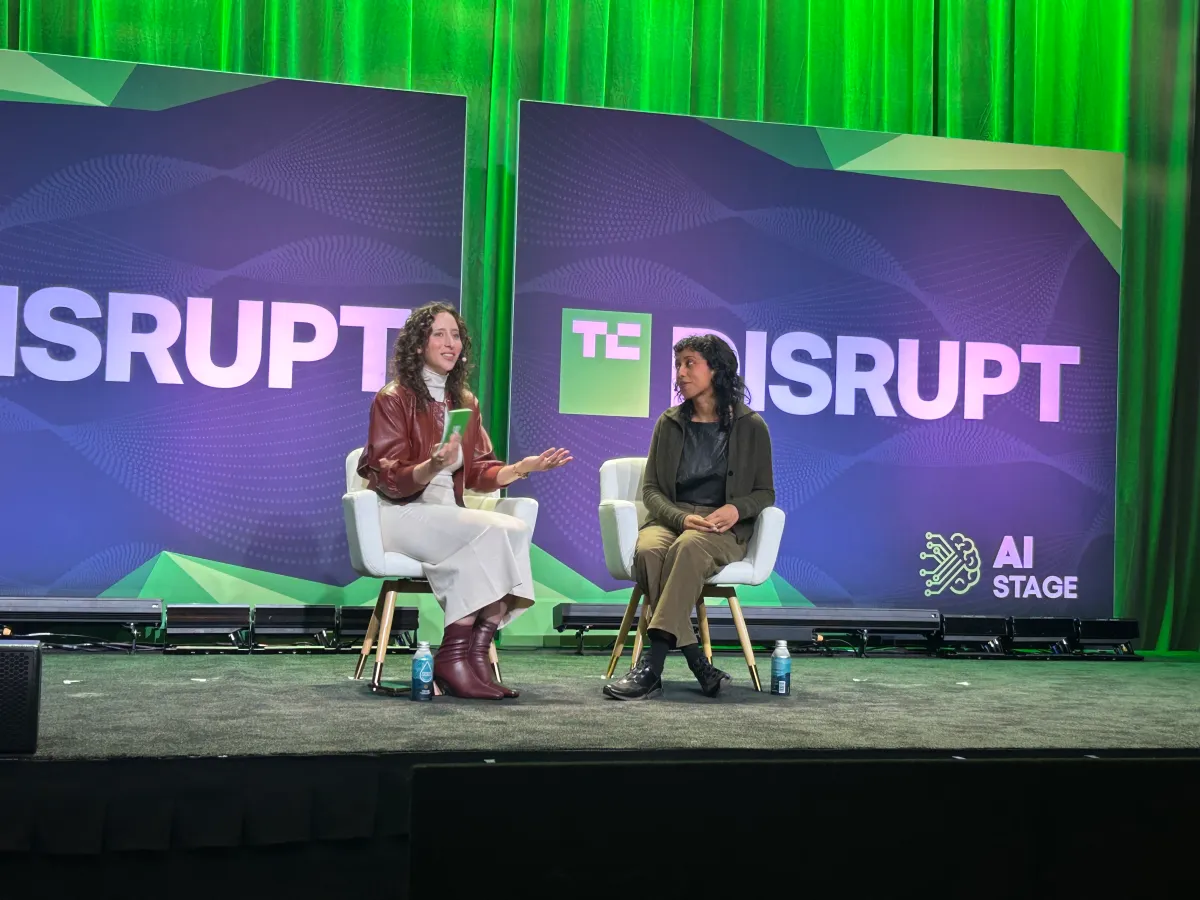
但这一前提正受到越来越多的质疑。日前,在 TechCrunch 举办的一场对谈中,Hugging Face 首席政策官 Irene Solaiman 直言,AI 评估方法“相当复杂,而且仍在成熟之中”。换句话说,今天被广泛引用的排行榜,远没有它们看上去那么可靠。
“裁判”进了赛场:嵌入式评估器的诱惑
面对外部评测的种种问题——基准泄露、数据污染、刷榜、评分者偏见——一种流行的思路是把评估机制直接嵌入模型或产品内部,让 AI 在运行过程中“自我打分”,或由内置的评估模块实时判断输出质量。这类“嵌入式 AI 评估器”(embedded AI evaluators)被一些人视为解决评估难题的捷径。
Solaiman 对此持谨慎态度。她指出,把评估器放进系统内部,并不能自动消除评估本身的复杂性和主观性;相反,它可能把不透明的问题藏得更深。一个由模型自己或厂商设计的评估模块,如何保证其标准与外部独立评测一致?当评估者与被评估者来自同一方,谁又来评估评估者?
评估并非一道可以“外包”给模型自己的工序,它是需要独立、透明且可被反复检验的基础设施——这正是 Solaiman 发言所传达的核心担忧。
基准测试的真正困境
要理解为什么“简单方案”并不简单,需要回到评估的几个结构性难题。
第一,污染的不可见性。当模型训练数据中混入了评测题目或答案,分数再高也失去意义。而模型厂商往往无法完整披露训练语料,外部研究者也难以逐一排查。
第二,指标的片面性。一个在数学题上得分高的模型,未必更安全、更有帮助、更少产生幻觉。把复杂能力压缩成几个数字,天然会丢掉大量信息。
第三,“用大模型当裁判”的循环依赖。用大模型给大模型打分,成本低、扩展快,但裁判模型自身的偏见会系统性地传导到结果里。当裁判和被评模型来自同一家族时,问题尤为严重。
Hugging Face 的立场与行业信号
作为开源模型社区的代表,Hugging Face 长期在开放评估工具与模型卡(model card)规范上投入。Solaiman 的提醒,也呼应了学界与政策圈近来的共同主张:评估需要走向“可审计”。这意味着评测数据集、提示词、评分细则、运行环境都应公开,结果应可被第三方复现,而不是只呈现一张漂亮的柱状图。
值得注意的是,监管层面也在提速。欧盟《人工智能法案》对高风险系统提出了评估与文档要求,美国若干州的立法草案同样把独立评估列为讨论重点。在这些框架下,评估不只是营销工具,更是合规链条的一环。
编者按:别让评估变成新式营销
过去两年,排行榜的更新速度几乎与模型发布速度同步,但公众对分数的信任却在下降。原因并不神秘:当评估由被评估者资助、由利益相关方设计、由同一批模型担任裁判,它就更像公关材料,而不是科学测量。
嵌入式评估器本身并非没有价值。在产品侧,它可以用于持续的运行时监控,及时发现质量漂移;在企业部署中,它可以充当合规护栏。但它的定位应是补充,而非替代独立的外部评测。若把“模型能给自己打分”当作问题已解决的证据,行业只会离可信评估更远。
Solaiman 的判断其实相当朴素:评估很难,而且短期内不会变简单。承认这一点,或许才是建立可信 AI 评估体系的起点。
本文编译自 TechCrunch
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接