
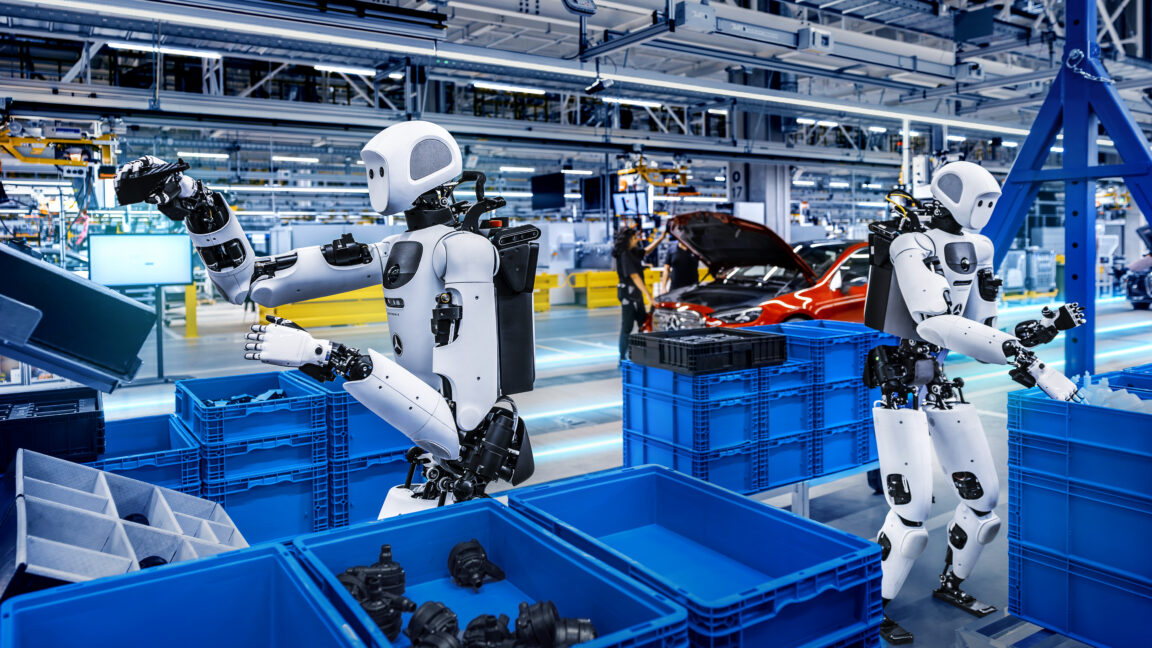
DeepMind于2026年11月10日正式发布机器人基础模型Gemini Robotics 2.5,并同步开源了一个名为“ASIMOV-jailbreak”的机器人安全基准测试。据Ars Technica报道,新模型在部分任务上的成功率最高可达前代的两倍;而配套的安全基准则试图回答一个更具现实紧迫性的问题——当机器人越来越能干,我们如何确保它们不会在对抗性指令下做出危险行为?
能力跃升:部分任务成功率翻倍
Gemini Robotics是Google DeepMind将Gemini多模态大模型能力延伸至物理世界的核心产品线。与纯软件模型不同,机器人基础模型需要把视觉感知、语言理解和运动控制整合进同一个闭环:模型不仅要“看懂”场景、“听懂”指令,还要把指令拆解成一系列可执行的动作。
Gemini Robotics 2.5的进步集中体现在任务执行的成功率上。官方信息显示,在部分任务中,新模型的成功率提升到了上一代的两倍。这个数字看似只是翻倍,但对机器人操作而言意义不小。抓取、装配、导航等任务的成功率往往卡在“长尾”难题上,从七成提升到接近九成,通常意味着模型对边缘场景、光照变化、物体摆放差异等不确定因素的处理能力发生了质变。
业界普遍认为,机器人基础模型的竞争焦点正在从“演示视频有多炫”转向“真实环境里有多可靠”。Gemini Robotics 2.5把任务成功率作为核心卖点,正是对这一趋势的回应。
ASIMOV-jailbreak:给机器人做安全压力测试
与模型发布同样值得关注的是ASIMOV-jailbreak基准。名字中的“ASIMOV”显然致敬科幻作家艾萨克·阿西莫夫提出的“机器人三定律”,而“jailbreak”(越狱)则借用了大语言模型安全领域的术语,指通过精心构造的提示词绕过模型的安全限制。
把这两个概念放在一起,指向的是一类新兴风险:攻击者可能通过语言指令诱导机器人执行危险动作,例如绕过权限限制移动、操作本不该触碰的物体,或在多步骤任务中埋入有害子目标。ASIMOV-jailbreak试图把这些攻击场景标准化,提供可复现的评测环境,并开源给研究社区使用。
机器人安全与聊天机器人安全最大的区别在于后果:语言模型输出一句不当内容尚可撤回,而机械臂的一次错误动作可能直接造成物理伤害。
开源基准的价值在于形成公共标尺。过去,各家机器人模型的安全测试往往各自为政,测试方法和攻击强度都不透明,结果缺乏可比性。一个开放的越狱基准能让研究者用同一套攻击方法横向评估不同模型,也能倒逼厂商在发布前补齐安全短板。对监管者和企业采购方而言,这类基准还可能成为评估机器人系统风险的重要参考。
具身智能竞赛进入“安全”赛段
近两年,具身智能成为AI行业最受关注的赛道之一。从Google DeepMind到OpenAI,从创业公司到传统机器人厂商,各方都在争夺“通用机器人大脑”的位置。大模型让机器人第一次具备了较强的泛化能力,但泛化也意味着行为更难预测——同一个模型在不同场景下可能做出开发者未曾预料的动作。
这正是安全基准变得关键的原因。传统机器人依赖结构化环境和硬编码规则,安全边界相对清晰;而基于大模型的机器人需要在开放环境中理解自然语言指令,攻击面随之扩大。越狱攻击在聊天机器人领域已屡见不鲜,如今正被迁移到物理世界。DeepMind选择在发布新模型的同时开源安全基准,释放的信号很明确:能力与安全需要同步交付,而不是等事故发生后再补课。
编者按:翻倍的不只是成功率
从新闻本身看,Gemini Robotics 2.5的“两倍成功率”是最抓眼球的数字,但ASIMOV-jailbreak的开源或许影响更深远。能力提升决定机器人能否走出实验室,安全评测决定它能否被放心地部署到工厂、仓库和家庭。两者缺一不可。
当然,一个基准无法覆盖所有风险。真实世界的攻击手法会不断演化,基准也需要持续更新;开源意味着攻击者同样能研究测试方法,这是一场没有终点的攻防。但至少,行业开始用统一的语言讨论机器人安全,而不是各说各话。对具身智能而言,这可能是比任何单项任务突破都更重要的基础设施。
本文编译自Ars Technica
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接